
授权转载声明
转载需先申请授权,并保留授权码、原文地址和文中 go/affiliate 链接。
原文地址:https://www.geekcorelab.com/post/using-wget-to-simulate-websites-under-linux
AI 摘要
wget命令用于从指定URL下载文件,具有稳定性和适应性强的特点。在网络条件不佳或不稳定的情况下,wget能够持续尝试下载直至完成。若下载过程中被服务器中断,wget会自动重新连接并从断点继续下载。这一功能特别适用于从限制链接时间的服务器下载大文件。命令参数包括递归下载、转换链接、获取页面必需元素、不追溯父级目录等,并可支持断点续传和生成日志文件。
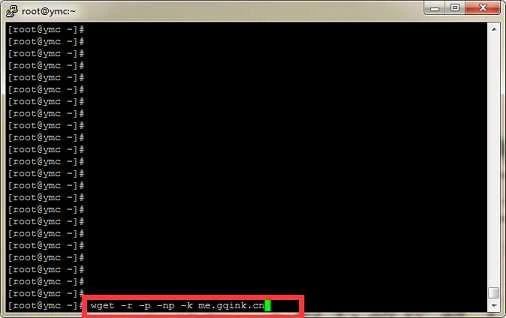
运行命令
wget -r -p -np -k me.gqink.cn
参数说明
-r --recursive(递归) specify recursive download.(指定递归下载)
-k --convert-links(转换链接) make links in downloaded HTML point to local files.(将下载的HTML页面中的链接转换为相对链接即本地链接)
-p --page-requisites(页面必需元素) get all images, etc. needed to display HTML page.(下载所有的图片等页面显示所需的内容)
-np --no-parent(不追溯至父级) don't ascend to the parent directory.
这里写代码片额外参数:
-nc  断点续传
-o   生成日志文件
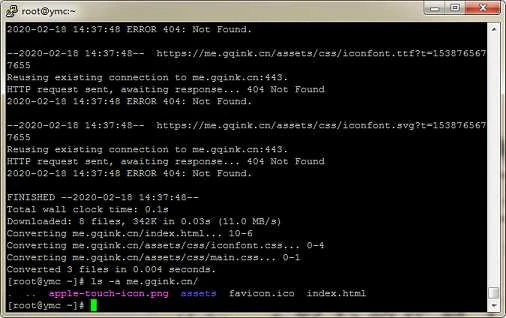
运行测试
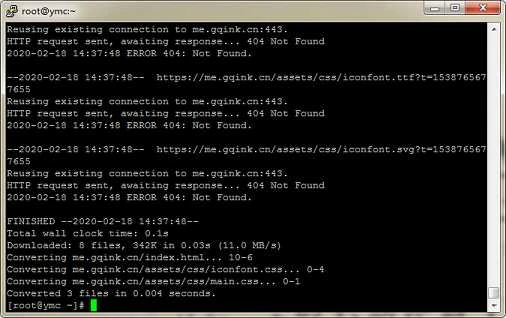
wget命令用来从指定的URL下载文件。wget非常稳定,它在带宽很窄的情况下和不稳定网络中有很强的适应性,如果是由于网络的原因下载失败,wget会不断的尝试,直到整个文件下载完毕。如果是服务器打断下载过程,它会再次联到服务器上从停止的地方继续下载。这对从那些限定了链接时间的服务器上下载大文件非常有用。
评论
参与讨论
请保持友善,共同维护良好的讨论环境。
讨论列表
0 条评论